غالبًا ما تصبح مخططات هيكل قواعد البيانات قديمة بسرعة لأنها تمثل لقطات ثابتة لقاعدة بيانات تتغير باستمرار. الحل الأفضل هو أتمتة توليدها مباشرة من قاعدة البيانات الحية الخاصة بك، مما يضمن دقتها دائمًا.
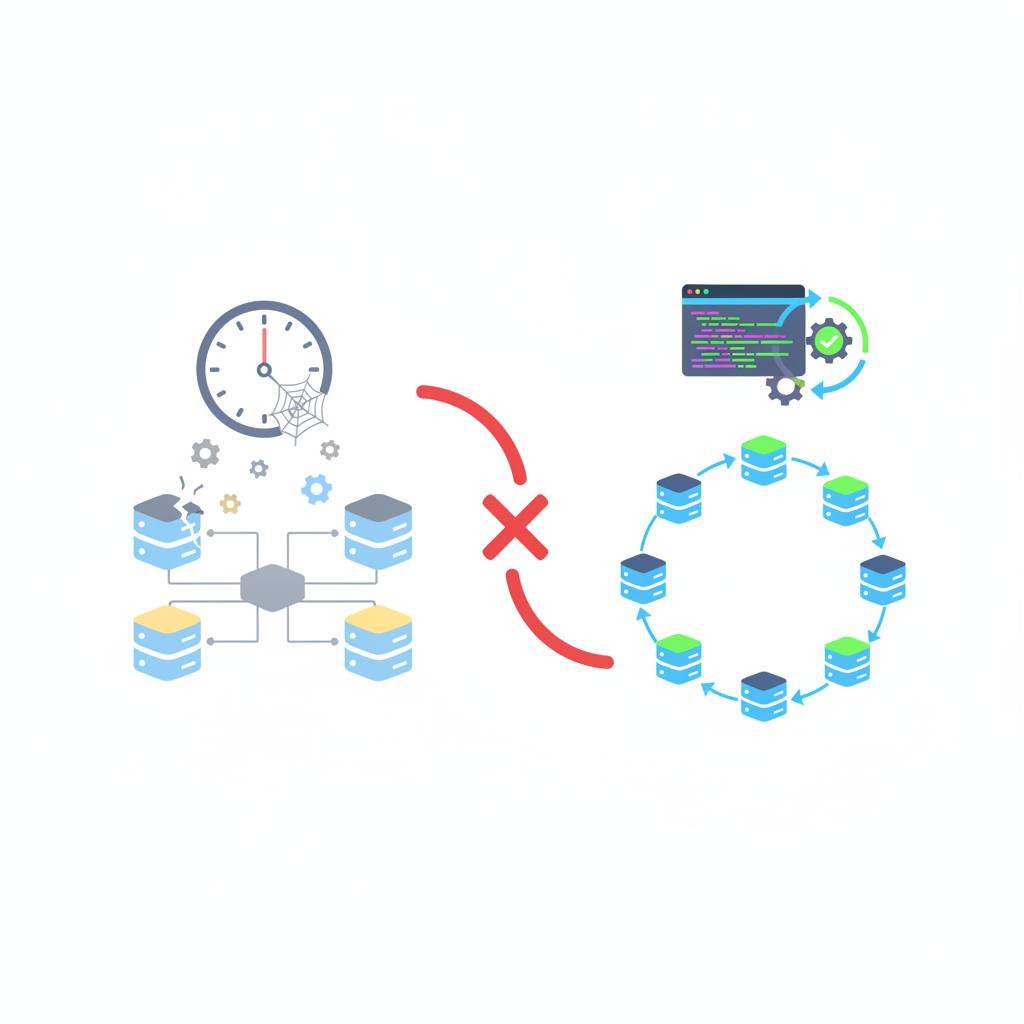
هل سبق لك أن نظرت إلى مخطط هيكل قاعدة بيانات ووجدته خاطئًا تمامًا؟ لست وحدك. هذه مشكلة شائعة لأن هذه المخططات هي لقطات ثابتة لهدف يتطور باستمرار – قاعدة بياناتك. ما يعنيه هذا بالنسبة لك هو أن فريقك قد يتخذ قرارات بناءً على معلومات قديمة، مما يؤدي إلى أخطاء مكلفة وسوء فهم.
تغييرات قواعد البيانات تحدث يوميًا. يضيف مطور عمودًا جديدًا، أو يعيد تسمية جدولًا من خلال ترحيل (migration)، وفجأة يصبح هذا المخطط الجميل المحفوظ في صفحة Confluence الخاصة بك، أو ملف Figma، أو كصورة ثابتة في مستودع التعليمات البرمجية الخاص بك، عديم الفائدة. الترحيل «يعمل فقط»، لذلك لا يفكر أحد في تحديث المخطط. غالبًا ما تقع مهمة الصيانة هذه في منطقة رمادية بين فرق الواجهة الأمامية والخلفية وعمليات التطوير (DevOps). يفترض الجميع أن شخصًا آخر سيهتم بها، وفي الواقع، لا أحد يفعل ذلك.
تحاول بعض الفرق إدارة هذا الأمر عن طريق تحديث ملف 'SCHEMA.md' يدويًا ضمن نفس طلب السحب (Pull Request) الذي يقدم تغييرًا في الهيكل. وقد يضيفون حتى «تم تحديث SCHEMA.md» إلى قائمة مراجعة طلب السحب الخاص بهم. ومع ذلك، تُظهر التجربة أن «لا أحد يفعل ذلك» بشكل موثوق. هذا النهج اليدوي عرضة للأخطاء البشرية وعدم الاتساق، مما يقوض الغرض من وجود مخطط دقيق.
الحل الأكثر فعالية وموثوقية حقًا هو توليد مخططات الهيكل الخاصة بك مباشرة من قاعدة البيانات الحية. يضمن هذا النهج أن مخططك دقيق بنسبة 100% دائمًا، حيث يستمد معلوماته مباشرة من مصدر الحقيقة الفعلي. فكر في الأمر على أنه «الخيار النووي» لسلامة المخطط.
يمكنك دمج عملية التوليد المؤتمتة هذه في خط أنابيب التكامل المستمر (CI) الخاص بك. على سبيل المثال، باستخدام أدوات مثل 'pg_dump' لاستخراج هيكل قاعدة البيانات الخاصة بك ثم إنشاء مخطط تلقائيًا من هذا الإخراج. من خلال تشغيل هذه الخطوة عند كل دفع (push) إلى فرعك الرئيسي، سيكون مخططك متأخرًا بتغيير واحد فقط عادةً، وهو دقيق بما يكفي للاستخدام اليومي العملي. تلغي هذه الطريقة التحديثات اليدوية، وتزيل أي تخمين حول من المسؤول، وتضمن حصول فريقك دائمًا على تمثيل محدث وموثوق لهيكل قاعدة بياناتك، مما يوفر الوقت ويمنع الأخطاء في النهاية.
تغييرات قواعد البيانات تحدث يوميًا. يضيف مطور عمودًا جديدًا، أو يعيد تسمية جدولًا من خلال ترحيل (migration)، وفجأة يصبح هذا المخطط الجميل المحفوظ في صفحة Confluence الخاصة بك، أو ملف Figma، أو كصورة ثابتة في مستودع التعليمات البرمجية الخاص بك، عديم الفائدة. الترحيل «يعمل فقط»، لذلك لا يفكر أحد في تحديث المخطط. غالبًا ما تقع مهمة الصيانة هذه في منطقة رمادية بين فرق الواجهة الأمامية والخلفية وعمليات التطوير (DevOps). يفترض الجميع أن شخصًا آخر سيهتم بها، وفي الواقع، لا أحد يفعل ذلك.
تحاول بعض الفرق إدارة هذا الأمر عن طريق تحديث ملف 'SCHEMA.md' يدويًا ضمن نفس طلب السحب (Pull Request) الذي يقدم تغييرًا في الهيكل. وقد يضيفون حتى «تم تحديث SCHEMA.md» إلى قائمة مراجعة طلب السحب الخاص بهم. ومع ذلك، تُظهر التجربة أن «لا أحد يفعل ذلك» بشكل موثوق. هذا النهج اليدوي عرضة للأخطاء البشرية وعدم الاتساق، مما يقوض الغرض من وجود مخطط دقيق.
الحل الأكثر فعالية وموثوقية حقًا هو توليد مخططات الهيكل الخاصة بك مباشرة من قاعدة البيانات الحية. يضمن هذا النهج أن مخططك دقيق بنسبة 100% دائمًا، حيث يستمد معلوماته مباشرة من مصدر الحقيقة الفعلي. فكر في الأمر على أنه «الخيار النووي» لسلامة المخطط.
يمكنك دمج عملية التوليد المؤتمتة هذه في خط أنابيب التكامل المستمر (CI) الخاص بك. على سبيل المثال، باستخدام أدوات مثل 'pg_dump' لاستخراج هيكل قاعدة البيانات الخاصة بك ثم إنشاء مخطط تلقائيًا من هذا الإخراج. من خلال تشغيل هذه الخطوة عند كل دفع (push) إلى فرعك الرئيسي، سيكون مخططك متأخرًا بتغيير واحد فقط عادةً، وهو دقيق بما يكفي للاستخدام اليومي العملي. تلغي هذه الطريقة التحديثات اليدوية، وتزيل أي تخمين حول من المسؤول، وتضمن حصول فريقك دائمًا على تمثيل محدث وموثوق لهيكل قاعدة بياناتك، مما يوفر الوقت ويمنع الأخطاء في النهاية.