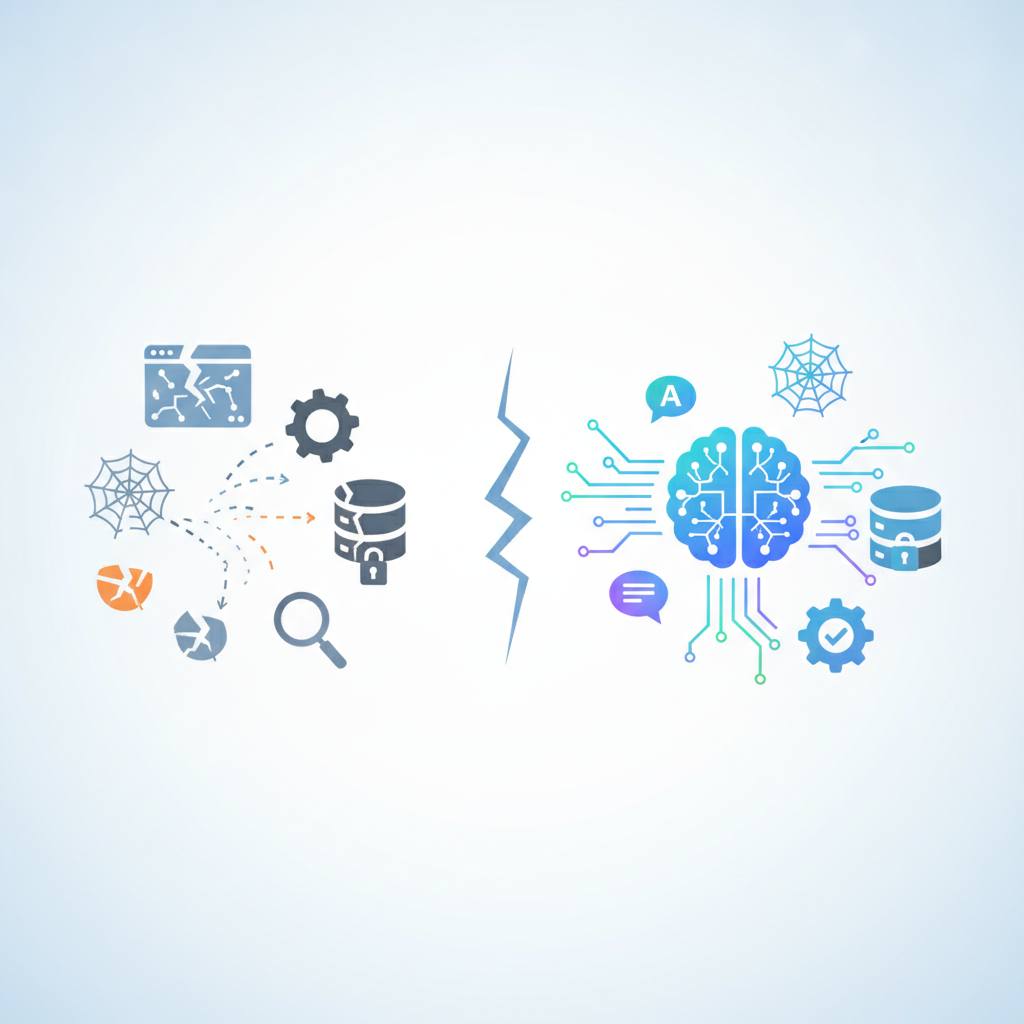
أدوات استخلاص البيانات التقليدية من الويب تتعطل كثيرًا بسبب تحديثات المواقع، لكن نهجًا جديدًا يجمع بين متصفحات الأتمتة ونماذج اللغة الكبيرة (LLMs) يخلق أدوات استخلاص بيانات موثوقة 'تُصلح نفسها'.
أهلاً بكم في وندتِك! هل تعاني من أدوات استخلاص البيانات من الويب التي تتوقف عن العمل فجأة؟ لقد وصلت إلى المكان الصحيح. لطالما كان استخلاص البيانات التقليدي من الويب يعتمد على طرق هشة مثل محددات CSS وتعبيرات XPath. المشكلة هي أنه بمجرد أن يقوم أي موقع ويب بتغيير بسيط في تصميمه الأمامي، كأن يغير أسماء فئات CSS أو يبدل ترتيب العناصر، تتوقف هذه الأدوات عن العمل فورًا وتنهار، مما يسبب إحباطًا كبيرًا ويضيع الوقت والجهد.
لكن لدينا أخبار سارة! هناك طريقة جديدة وذكية لإنجاز المهمة. أصبح بإمكان المطورين الآن استخدام مزيج من أدوات التشغيل الآلي للمتصفحات (مثل Playwright) مع نماذج اللغة الكبيرة (LLMs) لاستخلاص البيانات بطريقة منظمة. هذا يعني أنك تستطيع بناء أدوات استخلاص آلية لا تتأثر بتحديثات تصميم المواقع الإلكترونية. بدلًا من البحث عن أسماء فئات CSS جامدة، تستطيع نماذج اللغة الكبيرة قراءة الهيكل الدلالي لصفحات HTML وفهم معنى المحتوى، ثم استخلاص بيانات نظيفة ومحددة النوع على شكل كائنات JSON، وفقًا للمخططات التي تحددها.
تتمتع هذه النماذج بفهم عميق للغة الطبيعية، اتفاقيات التسعير، مواصفات المنتجات، وحتى تنسيقات العناوين. عندما تزودها بمحتوى HTML منظم جيدًا، يمكنها استخلاص العلاقات بين الكيانات بدقة عالية، وهي مهمة كانت تتطلب في السابق عشرات من التعبيرات العادية المعقدة والمعرضة للخطأ. عملية استخلاص البيانات الحديثة باستخدام نماذج اللغة الكبيرة تتبع خطوات واضحة: أولًا، يتم عرض الصفحة ديناميكيًا باستخدام متصفح 'بلاي رايت' الذي يقوم بتشغيل جافاسكريبت وينتظر حتى يتم تحميل الصفحة بالكامل. ثانيًا، يتم تنظيف وثيقة HTML الأصلية الكبيرة جدًا من أي نصوص برمجية أو أنماط أو صور غير ضرورية، مما يقلل حجمها بشكل كبير. أخيرًا، يتم تمرير هذا الجزء النظيف من HTML إلى نموذج اللغة الكبيرة مع مخطط لـ Zod أو JSON لاستخلاص البيانات بدقة. هذا الجيل الجديد من أدوات الاستخلاص هو حقًا خطوة كبيرة نحو جمع بيانات أكثر استقرارًا وموثوقية.
لكن لدينا أخبار سارة! هناك طريقة جديدة وذكية لإنجاز المهمة. أصبح بإمكان المطورين الآن استخدام مزيج من أدوات التشغيل الآلي للمتصفحات (مثل Playwright) مع نماذج اللغة الكبيرة (LLMs) لاستخلاص البيانات بطريقة منظمة. هذا يعني أنك تستطيع بناء أدوات استخلاص آلية لا تتأثر بتحديثات تصميم المواقع الإلكترونية. بدلًا من البحث عن أسماء فئات CSS جامدة، تستطيع نماذج اللغة الكبيرة قراءة الهيكل الدلالي لصفحات HTML وفهم معنى المحتوى، ثم استخلاص بيانات نظيفة ومحددة النوع على شكل كائنات JSON، وفقًا للمخططات التي تحددها.
تتمتع هذه النماذج بفهم عميق للغة الطبيعية، اتفاقيات التسعير، مواصفات المنتجات، وحتى تنسيقات العناوين. عندما تزودها بمحتوى HTML منظم جيدًا، يمكنها استخلاص العلاقات بين الكيانات بدقة عالية، وهي مهمة كانت تتطلب في السابق عشرات من التعبيرات العادية المعقدة والمعرضة للخطأ. عملية استخلاص البيانات الحديثة باستخدام نماذج اللغة الكبيرة تتبع خطوات واضحة: أولًا، يتم عرض الصفحة ديناميكيًا باستخدام متصفح 'بلاي رايت' الذي يقوم بتشغيل جافاسكريبت وينتظر حتى يتم تحميل الصفحة بالكامل. ثانيًا، يتم تنظيف وثيقة HTML الأصلية الكبيرة جدًا من أي نصوص برمجية أو أنماط أو صور غير ضرورية، مما يقلل حجمها بشكل كبير. أخيرًا، يتم تمرير هذا الجزء النظيف من HTML إلى نموذج اللغة الكبيرة مع مخطط لـ Zod أو JSON لاستخلاص البيانات بدقة. هذا الجيل الجديد من أدوات الاستخلاص هو حقًا خطوة كبيرة نحو جمع بيانات أكثر استقرارًا وموثوقية.