يحصل مساعد الذكاء الاصطناعي الخاص بك على نظام أمان جديد ومحسن. قبل اتخاذ أي إجراء خطير كإرسال الأموال أو حذف البيانات، يستخدم الآن نظامين مستقلين للتحقق لضمان موافقتك، مما يوفر لك حماية معززة.
هل تساءلت يوماً عن مدى أمان مساعدك الذكي عندما يكون على وشك القيام بشيء مهم؟ لدينا أخبار جيدة! تعتمد وكلاء الذكاء الاصطناعي في أندرويد الآن استراتيجية دفاع عميقة وذكية للحفاظ على أمان بياناتك وأموالك، مما يضمن التحقق مرتين قبل اتخاذ أي إجراء خطير. هذا يعني راحة بال أكبر لك عند التعامل مع مساعدك الرقمي.
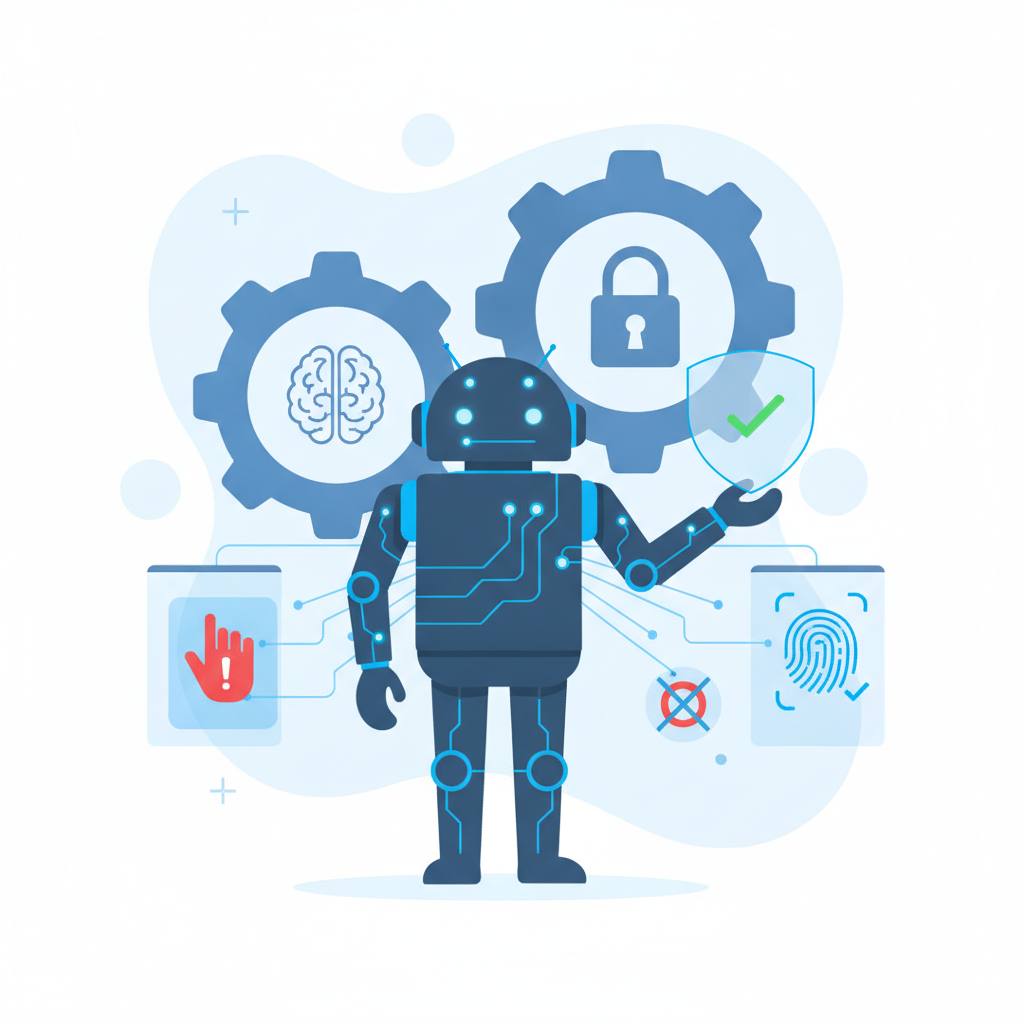
إليك كيف يعمل الأمر. تخيل أن وكيل الذكاء الاصطناعي الخاص بك على وشك إرسال رسالة، أو إجراء عملية دفع، أو حذف ملف. بدلاً من الاعتماد على شبكة أمان واحدة فقط، أصبح الآن يستخدم نظامين للتحقق مستقلين تماماً عن بعضهما البعض.
يأتي الفحص الأول من نموذج الذكاء الاصطناعي نفسه، وبالتحديد نموذج لغوي كبير (LLM). يستخدم هذا النموذج فهمه للإجراء ليقرر ما إذا كان 'يتطلب تأكيداً' منك. في معظم الأحيان، يصيب الذكاء الاصطناعي هذا التقدير. ومع ذلك، قد يؤدي طلب غير عادي أو نوع جديد من الإجراءات أحياناً إلى إرباك النموذج، مما يجعله يفوت تصنيف مهمة خطيرة. لو كان هذا هو الضمان الوحيد، فقد يتم تنفيذ إجراء خطير دون موافقتك الصريحة.
وهنا يأتي دور الفحص الثاني: 'حارس الكلمات الرئيسية'. هذا الحارس بسيط جداً عن قصد. إنه لا يحاول فهم سياق أو ذكاء الإجراء. بدلاً من ذلك، يقوم فقط بمسح نص الزر أو نص الإجراء بحثاً عن كلمات خطيرة محددة مثل 'إرسال'، 'دفع'، 'حذف'، 'تحويل'، أو 'شراء'. لقد تم تصميمه ليكون 'غافلاً' بأفضل معنى للكلمة — لا يمكن خداعه بالسياق، ولا يمكن أن يهلوس. إذا وجد كلمة خطيرة، فإنه يشير إلى الإجراء، بغض النظر عما اعتقده النموذج اللغوي الكبير.
لا يثق أي من هذين الطبقتين بالآخر، وهذا هو سر قوتهما. النموذج اللغوي الكبير يلتقط الحالات التي يفهمها، بينما يلتقط حارس الكلمات الرئيسية الحالات التي قد يفوتها النموذج بسبب تعقيده أو لحظة سهو. معاً، يشكلان حاجزاً أقوى بكثير ضد الإجراءات غير المقصودة. لذا، في المرة القادمة التي يطلب فيها مساعدك الذكي تأكيداً، ستعرف أن هناك فحصين يقظين يعملان خلف الكواليس لحمايتك.