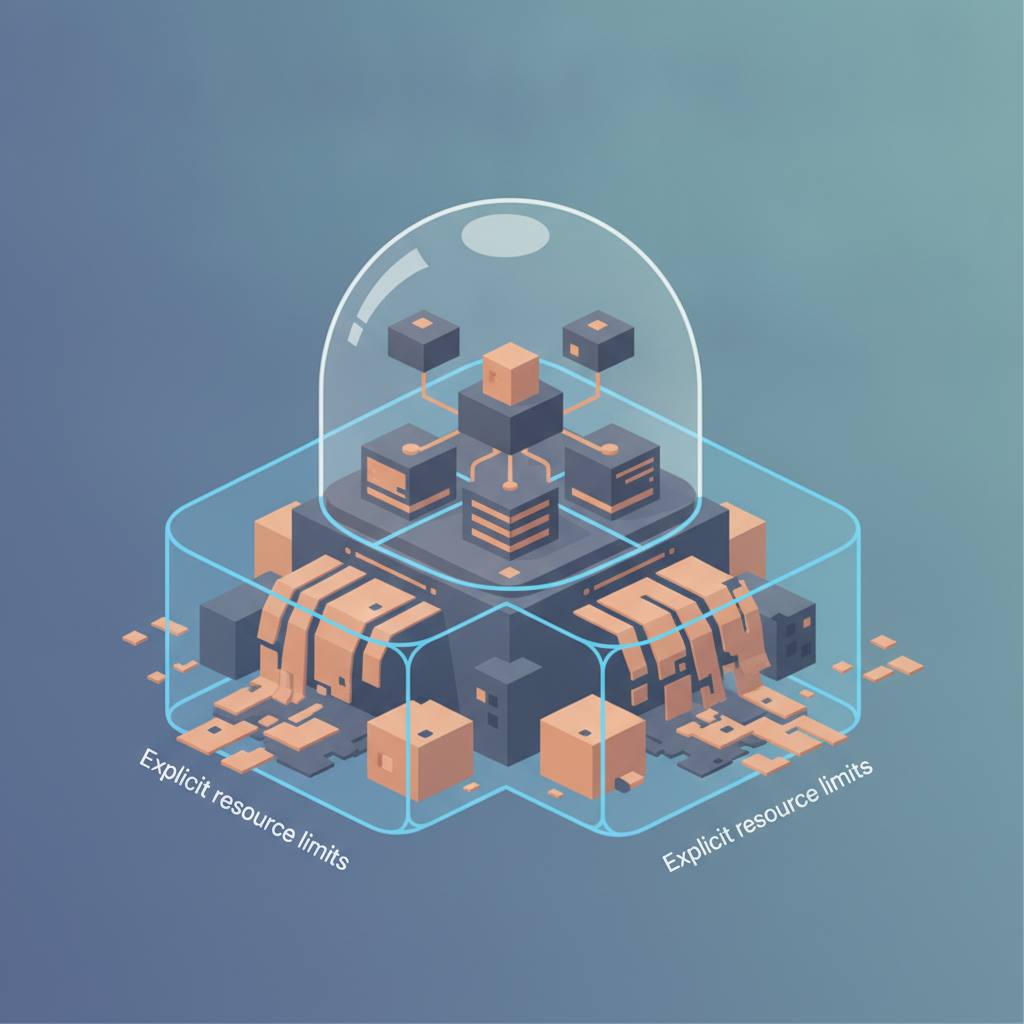
ترك حدود موارد Kubernetes غير محددة يمكن أن يؤدي إلى تعطل خدماتك. اكتشف لماذا يعد تحديد سقف صريح لوحدات المعالجة المركزية والذاكرة أمرًا حيويًا لبيئات الإنتاج المستقرة.
مرحباً بقرّاء WondTech الأعزاء! إليكم نصيحة بالغة الأهمية لكل من يدير تطبيقاته على Kubernetes: **تحديد حدود الموارد الصريحة أمر غير قابل للتفاوض أبداً إذا كنت تسعى لبيئة إنتاج مستقرة.** ماذا يعني هذا لك؟ حسناً، إنه يعني منع تلك الأعطال المحبطة التي يسببها حاوية واحدة سيئة السلوك.
تخيل هذا السيناريو: تطبيق جديد يهبط على خادم مشترك، وفجأة تبدأ إحدى حاوياته بالتهام كل الذاكرة أو وحدة المعالجة المركزية المتاحة. قبل أن تدرك، تبدأ التطبيقات الحيوية الأخرى على نفس الخادم بالفشل لأنها حرمت من الموارد. غالباً ما يؤدي هذا إلى تدخل 'قاتل الذاكرة' (OOM killer) في Kubernetes، الذي ينهي عمليات حاويات لا علاقة لها بالمشكلة، محولاً بذلك مشكلة صغيرة إلى حادث كبير يتجاوز اتفاقيات مستوى الخدمة (SLAs) الخاصة بك. لقد مررنا جميعاً بذلك – انتقال خادم من 70% إلى 100% من الذاكرة في دقائق، مما يتسبب في فوضى عارمة.
ما هو جذر هذه المشكلة؟ العديد من إعدادات Kubernetes تترك طلبات وحدود الموارد على قيمها الافتراضية '0' (غير محدودة). يحدث هذا لأن واجهات المستخدم قد تخفي هذه الحقول المهمة، أو أن مخططات Helm تتجاهلها من أجل التبسيط. ولكن بدون حدود واضحة للذاكرة ووحدة المعالجة المركزية، يمكن لحاوياتك أن تستهلك قدر ما تشاء من الموارد، بشكل مباشر ضد التسلسل الهرمي لمجموعات التحكم (cgroup) في الخادم. هذا هو بالضبط سيناريو 'الجيران المزعجين' الذي نحاول تجنبه.
الحل بسيط ولكنه قوي: حدد دائماً `resources.requests` و `resources.limits` في مواصفات حزمة التطبيقات (pod specifications) الخاصة بك. يخبر حقل `requests` مُجدْول Kubernetes بكمية وحدة المعالجة المركزية والذاكرة التي *يحتاجها* حزمة التطبيقات الخاصة بك، مما يساعده على وضع حزمة التطبيقات على خادم به مساحة كافية. أما حقل `limits`، فهو يمثل الحد الأقصى الصارم. إنه يخبر نواة نظام التشغيل بتقييد استخدام وحدة المعالجة المركزية أو تشغيل إيقاف التشغيل بسبب نقص الذاكرة (OOM kill) *فقط* لهذه الحاوية المحددة إذا تجاوزت مواردها المخصصة. هذا يوقف الحاوية المارقة من التأثير على الآخرين.
بالطبع، تحديد الحدود ليس خالياً من الاعتبارات. قد يصل التطبيق المقيد بشدة إلى حدوده بشكل أسرع، مما يتطلب منك ضبط قوائمه الداخلية أو تمكين التدهور التدريجي. أيضاً، تخصيص حدود مفرطة يعني أنك قد تحتاج إلى المزيد من عقد الخادم، مما يؤثر على التكاليف. لكن البديل – عمليات إخلاء الخدمة غير المتوقعة ووقت استعادة الحوادث الأطول – غالباً ما يكون أسوأ بكثير. أخيراً، ستحتاج إلى مراقبة مقاييس cgroup مثل اختناق وحدة المعالجة المركزية وأحداث OOM للتأكد من أن حدودك مناسبة. في النهاية، تؤدي الحدود المحددة جيداً، استناداً إلى فهم ملف تعريف حمولة عملك والمختبرة بشكل مثالي بهندسة الفوضى، إلى خدمات أكثر قابلية للتنبؤ وموثوقية.